
AI意思決定モデル:何であるか、選べるモデル、エンタープライズの活用
市場情報の確認日:2026年10月7日。
調達の担当チームに、仕入先から何百通ものメールが届く場面を想像してください。新しい提案もあれば、納期の遅れを知らせるものもあり、すぐ対応が必要なものも混ざっています。返信を書く前に、誰かが各メッセージの行き先を決める必要があります。
これは、AI意思決定モデルを検討する価値のある仕事です。もう一段落を書くことではなく、ソフトウェアが使える判断を返すことです。
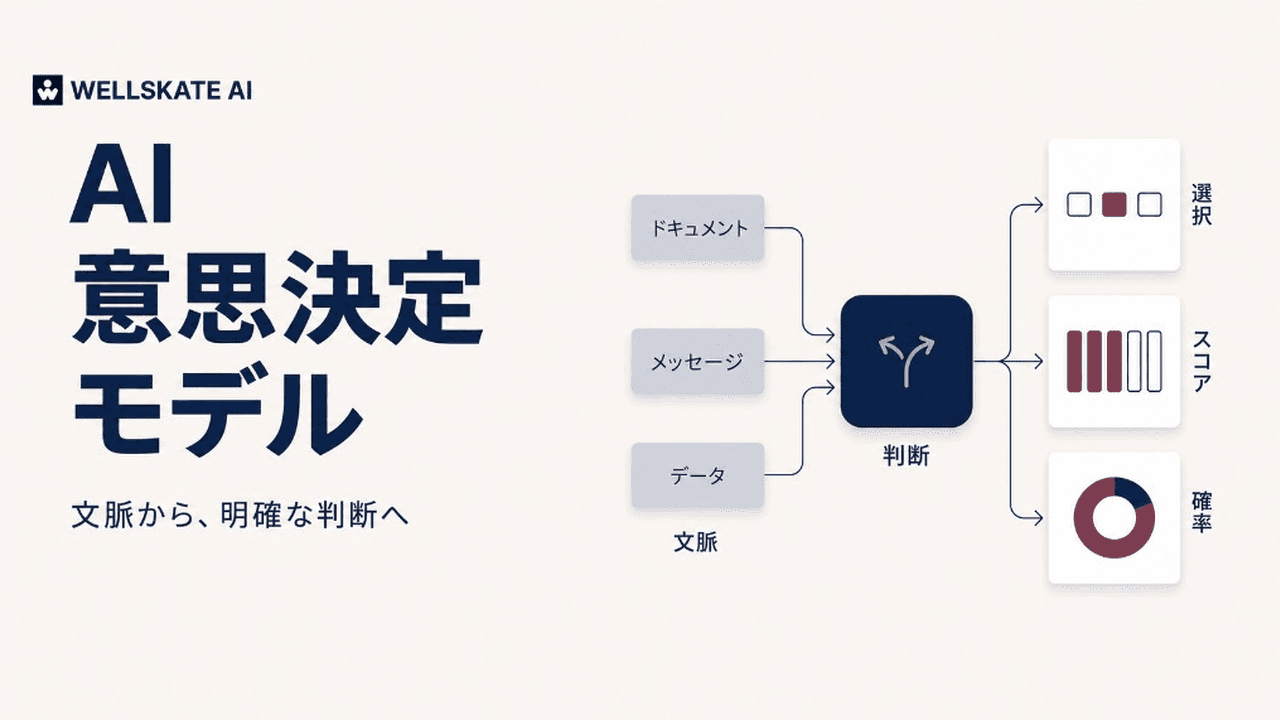
意思決定モデルは、渡された情報を決められた問いに照らして評価し、カテゴリ、スコア、確率のような範囲の決まった答えを返します。その出力は、仕事の振り分け、キューの優先順位、人による確認の依頼に使えます。自由な文章生成とは、担う役割が違います。
事業にとって有用な問いは、「どのモデルが一番賢いか」ではありません。どの判断を、どの根拠で、誰の権限のもとで自動化するかです。
AI意思決定モデルとは
この記事での意思決定モデルは、渡された文脈について、制約のある問いに答えるよう設計されたAIモデルを指します。従来の経営フレームワークや、意思決定管理の基盤全体のことではありません。
典型的なリクエストには、三つの要素があります。
- 文脈: 評価するメッセージ、文書、画像、またはアプリケーションの状態。
- 問い: 必要とする具体的な判断。
- 許される答え、または評価基準: アプリケーションが受け付けるカテゴリ、条件、採点の段階。
実装によって、応答には選ばれた答え、候補ごとの確率、そして別の確信度が含まれることがあります。入力の種類と、返る数値の意味は提供者ごとに異なります。
仮の仕入先受信箱であれば、たとえば次のような問いです。
- 選択: このメッセージは、調達、物流、買掛、人手による確認のどれに回すか。
- スコア: 緊急度はどの程度か。日常の連絡から、生産が止まる遅れまでの基準で評価する。
- はい/いいえの確率: 振込先の変更を求めているか。
これらは説明のための問いであり、モデルを試した結果ではありません。
いくつかのAPIは、これらの問いを choice、score、noul と呼びます。noul は、はい/いいえの条件が真である確率で、0から1の値です。OpenAIのDecisions APIは、はい/いいえを predicate、残りを choice と score と呼びます。名前より、返ってきた数値が何を表すかのほうが大切です。
LLMや分類器と何が違うか
文章を組み立てるのではなく、選ぶ
専用の意思決定モデルは、許可された答えを、返答の文章を一トークンずつ生成せずに採点できます。ただし、設計は一つではありません。Layaはエンコーダを使い、CloudflareのClefは言語モデルのバックボーンを、自己回帰でない意思決定の採点に適応させています。「意思決定モデル」は役割とインターフェースの名前であり、単一のモデル設計ではありません。
この特化は、分類を繰り返す処理で速さの利点になり得ます。あらゆる代替より、あらゆる仕事で速く、安く、正確だという意味にはなりません。Cloudflare自身の比較でも、品質と遅延はタスクによって分かれています。
構造化された出力は、意思決定への特化と同じではない
生成LLMも、スキーマに沿った出力をすでに返せます。段落からカテゴリを抜き出す必要は、必ずしもありません。違いは、モデルの予測のしかた、確率の情報、そのタスクへの適性です。応答が正しいJSONであることだけではありません。形式が合っていても、内容が正しいとは限りません。
分類そのものは新しいものではない
従来の分類器、ゼロショット分類器、意思決定モデルは重なります。呼び出し側がラベルを定義できるゼロショット分類器もあります。新しい意思決定モデルの提供は、型のある複数の判断と確率の出力を、アプリケーションの処理向けにまとめたものです。分類を発明したわけではありません。
実務での選び方は次のとおりです。
- ルールを使う。 信頼できる項目と明示的な条件で、すでに答えが決まるとき。
- 分類器を評価する。 ラベル付けの仕事が明確なとき。
- 意思決定モデルを評価する。 構造化されていない情報に対し、範囲の決まった判断を繰り返すとき。
- 生成モデルや推論モデルを使う。 計画、説明、抽出、または新しい文章が必要なとき。
これらは、同じアプリケーションの中で併用できます。
いま使える意思決定モデル
以下は、文書化されたAPIを持つ商用の意思決定モデルを、2026年10月7日に確認した抜粋です。「使える」とは、提供者がエンドポイントまたはモデルカードを公開しているという意味です。セキュリティ、データの所在、本番要件を満たす認定ではなく、順位でもありません。
見出しのベンチマークだけで選ばないでください。 公開された評価は、データセット、ハードウェア、配信の構成、遅延の定義が異なります。たとえばPerplexityのクイックスタートは、2026年9月30日の試験におけるAPIの往復時間を報告しています。他の提供者はモデル時間や、自社の計測環境での中央値を公開しています。これらの時計は同じものを測っていません。一つの比較の中でも、あるタスクでは先行し、次のタスクでは後れることがあります。Cloudflareが10月1日に出した表がその例です。意図の分類やツール選択のいくつかではClefがリードし、個別のタスクでは他のモデルがリードしています。
これらのAPIの多くは形が共通です。文脈を送り、型のある問いを一つ以上付けます。choice は定義したラベルから一つを選び、選択肢ごとの確率を返します。score は順序のある基準の上に入力を置き、確率で重み付けした平均なので、段階のあいだの数値になり得ます。noul(OpenAIのAPIでは predicate)は、条件が真である確率を返します。choice と score では、別の confidence を返す提供者もあります。Perplexityのクイックスタートは、これが勝った選択肢の確率と同じ数値ではないと明示しています。しきい値に使う前に、各提供者の定義を読んでください。
下表の価格は、各提供者が公開している100万トークンあたりの入力単価です。これらの意思決定エンドポイントでは、出力トークンは課金しないと提供者は述べています。ゲートウェイ、地域処理、長い文脈の倍率で請求は変わります。予算を組む前に、現行の料金を確認してください。
| 提供 | 問いの型 | 文書化された入力 | 入力の定価 |
|---|---|---|---|
| TypeSafe Jev 1.13 | choice、score、noul | テキスト | $0.042 |
OpenAI Decisions(gpt-6-luna、パブリックベータ) | predicate、choice、score | テキストと画像 | $0.10 |
| Perplexity Decider v1 と v1.1(27B) | noul、choice、score | テキスト、JSON、埋め込み画像 | $0.02 |
| Cloudflare Clef / Clef-flash | noul、choice、score | テキスト、JSON、画像、動画 | $0.24 / $0.09 |
| Liquid AI d1 | noul、choice、score | ネイティブAPIではテキストと画像 | $0.04 |
TypeSafe Jev
JevはTypeSafeのSystem Oneモデルであり、その後の多くの意思決定APIが踏襲するインターフェースです。文書化されている現行リリースはJev 1.13(jev-1.13.0)で、別名 jev-latest でも呼べます。エンドポイントは POST /v1/systemone です。
Jevが受け付けるのはテキストです。文字列、JSONオブジェクト、またはテキスト値の配列です。モデルのページでは、画像、音声、動画は受け付けません。TypeSafeは、状態とすべての問いを合わせて64,000トークン、状態と最も長い一つの問いを合わせて32,000トークンの予算を文書化しています。定価は入力100万トークンあたり$0.042です。主な学習言語は英語で、TypeSafeはCJKを含む他の言語について、自社の内容で試すよう述べています。同じリクエストの形はOpenRouterからも使えます。
OpenAI Decisions API
OpenAIのDecisions APIはパブリックベータで、一般提供は今後数週間と説明されています。現在このエンドポイントで使えるモデルは gpt-6-luna だけで、呼び出しは POST /v1/decisions です。
三つの問いの型は predicate、choice、score です。入力はテキスト、または画像を含むユーザーメッセージです。OpenAIのガイドは、製品写真を predicate の例にしています。目に見える損傷がある確率です。同じガイドは、Responses APIの約10倍の速さで型のある答えを返すと述べています。これはOpenAIが自社の生成エンドポイントと比べた数字であり、提供者を横断した順位ではありません。
このエンドポイントの文書化された価格は、入力100万トークンあたり$0.10です。キャッシュの読み書きと出力トークンの課金はありません。地域の割増と、長い文脈の入力倍率は適用され得ます。OpenAIはまた、対象の顧客についてゼロデータ保持とHIPAAに対応し、データの所在は米国と欧州(EEAとスイス)だと述べています。対象になるかどうかは、現行のデータ管理条件によります。
Perplexity Decider
PerplexityのDecisions APIは POST https://api.perplexity.ai/v1/decisions で答えます。文書化されているモデルは pplx-decider-v1.1-27b と pplx-decider-v1-27b です。状態はテキスト、JSON、または画像です。画像は埋め込んだPNG、JPEG、WebPのデータURLである必要があり、APIは遠隔の画像URLを取得しません。
問いの型は noul、choice、score です。一つのリクエストに最大128の問いを載せられ、入力の上限は262,144トークン未満です。現行の定価は入力100万トークンあたり$0.02で、出力トークンは無料です。Perplexityのクックブックは実務的な分け方を示しています。意思決定モデルがサポートチケットを振り分け、エスカレーションされたチケットだけが生成エージェントに進みます。
Cloudflare Clef と Clef-flash
Cloudflareは2026年10月1日、Workers AIでClefとClef-flashを公開しました。@cf/cloudflare/clef(27B)と @cf/cloudflare/clef-flash(9B)です。重みはApache 2.0ライセンスで公開されています。どちらもSystem Oneの問いの型に従うので、Jev形式のリクエストはエンドポイントとモデルを変えればClefに向けられます。
Clefは言語モデルのバックボーンを使い、返答を一トークンずつ生成せずに、許された答えを採点します。Workers AIのモデルページは、65,536トークンのコンテキストを記載し、テキスト、JSON、画像、動画を受け付けます。ホストされた画像入力は埋め込みで、最大4枚です。遠隔の画像URLは受け付けません。定価は入力100万トークンあたり、Clefが$0.24、Clef-flashが$0.09です。CloudflareはClefの伴走型ファインチューニングも説明しており、その後にセルフサービスの学習機能を予定しています。
Cloudflareの公開記事は、サポートの振り分け、ドメインの分類、信頼と安全の評価基準、エージェントのガードレール、画像の分類にClefを使っています。これらは文書化された用途です。同じ記事のベンチマーク表はタスクによって結果が分かれるので、自社のデータで試す理由にはなります。試験を省く理由にはなりません。
Liquid AI d1
Liquid AIは2026年10月5日、d1の画像対応を発表しました。ネイティブAPIのモデルIDは d1 で、エンドポイントは POST https://api.liquid.ai/decisions/v1/systemone です。テキスト、画像、またはその両方を受け付け、noul、choice、score に答えます。Liquidは、テキストの判断に約200から300ミリ秒かかり、d1は入力100万トークンあたり$0.04で、画像も入力トークンとして数え、出力トークンは課金しないと述べています。
VercelとOpenRouterでは、Liquidはd1をテキストで提供し、これらのゲートウェイでの画像対応はまだ予定だと述べています。発表の例には、サポートチケットの選別、文章のフォルダ分け、ウェブエージェントの次の許可された操作の選択、ツール出力の圧縮、生産ラインの写真の確認が含まれます。その記事の精度と費用の比較は、Liquidが生成モデルに対して行った自社の評価です。提供者の結果として扱い、実際に使う文書でd1を測ってください。
自分で動かすときのオープンウェイト
Clefの重みは、ローカルで試す一つの道です。Convai InnovationsのLayaは、別のオープンウェイトの意思決定モデルです。双方向のエンコーダが、渡した選択肢を採点し、choice、score、noul の確率を返します。英語チェックポイントの既定の予算は問いあたり512トークンで、上に挙げた長い文脈のホスト型APIとは向きが違います。Laya自身の注記では、出荷時の確率は、選択肢の数ごとに保留データで較正するまで過信になり得るとされています。
関連するリクエスト形式を使うホスト型や実験的なモデルは、ほかにもあります。この一覧は、2026年10月7日に一次資料を確認できた範囲です。動きます。
名前が並んだあとに比べる価値があるのは、次の点です。
- 根拠がテキストか、写真や画面キャプチャも含むか
- 実際の案件に必要な文脈の量
- ホスト型APIか、オープンウェイトか、ファインチューニングか
- データの取り扱い、所在、ベータの状態
- 画像と再試行を含む、トークン構成ごとの価格
- 業務から取ったラベル付き集合での品質と、確率が較正されているか
意思決定モデルのエンタープライズ活用
出発点として勧めるのは、頻繁で範囲が狭く、誤りを測れ、下流の操作を戻せる判断です。以下は処理の設計例であり、性能を保証する主張ではありません。
1. 届いた仕事の振り分けと優先順位
試行の案: 仕入先のメッセージを、調達、物流、買掛、人手による確認に分類する。緊急度は、明示した基準で別に採点する。
カテゴリと緊急度は分けてください。日常の配送連絡と、生産が止まる遅れは、同じチームの担当でも、必要な注意は違います。
サポートの振り分けとエージェントのルーティングは、意思決定モデルの文書化された用途です。試行では、平均の正解率だけでなく、誤った振り分け、緊急案件の見落とし、確認者による上書きを測ってください。
2. 文書と知識の選別
試行の案: 仕入先の説明を生成する前に、取得した各箇所が納入実績、取引条件、無関係な話題のどれに当たるかを評価する。
Liquidのd1の発表は、チケットの選別と、文章のフォルダ分けを説明しています。この形は、関連性を見る候補の層として扱ってください。検索の構成要素をすべて自動で置き換えるものではありません。
勧めたい安全策は、採用した箇所だけでなく、除外した箇所も抜くことです。最も重要な根拠をフィルタが黙って除いていたなら、整った説明は役に立ちません。
3. AIが作った成果物の評価
試行の案: 仕入先への返信案が、述べられた問題を認め、足りない情報を求め、まだ完了していない作業を完了したと書いていないかを確認する。
score の問いは、順序のある基準に沿って下書きを採点できます。下書きが良いかを一括で聞くより、範囲が狭い仕事です。自動の評価そのものも、人の判断と照合してください。
「これは良い返信か」のような曖昧な一つの問いではなく、観察できる基準を分けて書いてください。
4. エージェントの次の許可された操作を選ぶ
試行の案: 注文記録の取得、確認の質問、返信の下書き、エスカレーションのなかから、エージェントに選ばせる。
操作の選択は、意思決定APIの文書化された用途です。Liquidのウェブエージェントの例や、ツールを使う前に確認するCloudflareの説明が含まれます。アプリケーションが許可された選択肢を渡すべきです。推薦を、無制限の権限として解釈してはいけません。
認証、ツールの権限、承認の要件は、予測の外に置いてください。「記録を更新する」というラベルを選んだだけで、モデルがその更新の権限を得るべきではありません。影響の大きいツール利用では、人の承認と層になった制御が引き続き重要です。ヒューマンインザループは、その停止の設計です。
5. 画像による一次確認
試行の案: 損傷がありそうな梱包の写真に印を付け、印が付いたものや判断が難しいものを検査担当に回す。
OpenAIのDecisionsガイド、PerplexityのDecisions API、Cloudflare Clef、Liquidのネイティブなd1 APIは、画像入力を文書化しています。Jevの現行モデルページはテキストのみです。画像に対応していることは、目視の一次確認を候補にする理由にはなります。あらゆる検査環境に適する証明にはなりません。
試行では、実際の照明、カメラの角度、まれな欠陥を試してください。より影響の大きい自動化を考える前に、注意を向ける順番を付けるために使ってください。
意思決定モデルに単独でさせないこと
範囲の決まった答えが、正しい答えであるとは限りません。高い確率が、権限を生むわけでもありません。
仕入先の例では、「取引先が振込先の変更を求めている」は解釈です。「その変更は正当で、承認済みである」には、別の確認が必要です。この区別を処理の中で明示してください。
同様に、確認者が根拠を必要とするとき、構造化されたラベルが説明の代わりにはなりません。形式が正しくても、構造化された出力は内容を誤ることがあります。
勧めは、取り消せない操作や影響の大きい操作の責任は人が持ち、意思決定モデルはまず振り分け、補助、確認の優先順位に使うことです。
意思決定モデルの選び方と導入
1. モデルを選ぶ前に、判断を定義する
入力となる根拠、許される結果、各結果の意味、下流で起きること、を書き出します。情報がないときや曖昧なときの確認経路も含めます。
再利用できる型: 「[根拠]が与えられたとき、[一つの問い]を[許される結果]に分類する。結果は[許された操作]を起動してよい。[制限された操作]は決して起動しない。」
2. 代表性のある試験集合を作る
通常の案件、矛盾する根拠、不完全な入力、チームが実際に使う言語の例を含めます。モデル開発用のデータと、最終評価の集合は分けます。
3. 勝ったラベルだけでなく、確率を評価する
較正とは、確率の見積もりが観測された正解率と対応しているかを問うことです。モデルは、見栄えのする数値を返しながら、よく較正されていないことがあります。確信度が90%近い予測が、自社のデータではそれよりかなり低い割合でしか当たっていないなら、そのしきい値は期待どおりに働いていません。
各提供者のconfidenceの定義も確認してください。選ばれた答えの確率とは違うことがあります。
4. 誤りの影響に合わせてしきい値を置く
ラベル付きの業務例を使い、偽陽性と偽陰性を分けて考えてしきい値を選びます。メールの振り分けで許容できるしきい値が、重大インシデントのエスカレーションには不適切なことがあります。OpenAIの意思決定の文書は、このアプリケーションごとのやり方を明示して勧めています。
5. 処理全体を測る
勧める記録項目は次のとおりです。
- 自動で処理した案件のうちの誤り率。
- 人の確認が必要な案件の割合。
- 端から端までの遅延の中央値と裾。
- 再試行、ホスティング、確認を含む総費用。
- 言語と、判断のカテゴリごとの性能。
- サービスが失敗したときの回復のしかた。
6. シャドーモードから始める
まず、モデルがどう判断したかを記録し、実行はさせません。その判断を実際の結果と比べます。根拠が支持するところだけ自動化を広げ、問い、方針、モデルの版が変わるたびに評価をやり直します。
結論:自動化するのは判断であり、責任ではない
意思決定モデルを評価する価値があるのは、生成された文章がもう一つ必要なのではなく、明確な選択が必要なときです。最も強い出発点は、可能な限り広いエージェントではありません。結果を理解している、一つのはっきりした判断です。
WellSkate AIにとっての実務的な問いは、実際の仕事の中でAIをどう役立てるかです。WellSkate AIは、コードなしで独自のAIエージェントを作れるようにします。
AIエージェントがチームのどこを助けられるか、見てみませんか。 WellSkate AIのデモを予約し、改善したい繰り返しの業務を一つ持ってきてください。contact@wellskate.ai への連絡もできます。
上のモデルは市場の例です。掲載は、WellSkate AIへの標準搭載や連携を意味しません。